우리는 모든 AI 문제에, 심지어 단순한 판단에까지 LLM을 망치처럼 사용해 왔습니다. Jev는 그런 판단을 밀리초 단위로, 그리고 훨씬 적은 비용으로 처리합니다. 이 모델이 어떻게 작동하고 어디에 들어맞는지 함께 살펴보겠습니다.
TypeSafe AI는 2026년 9월 15일에 Jev를 공개했는데, 대화를 나누지도 못하고 코드를 작성하지도 못하며 쓸 만한 문단 하나조차 생성하지 못하는 모델치고는 반응이 유난히 뜨거웠습니다.
그런데 바로 그 한계가 핵심입니다.
대부분의 소프트웨어에는 챗봇이 하나 더 필요하지 않습니다. 정작 필요한 일은 수천 건의 작은 판단을 내리는 것입니다. 예를 들면 이런 판단들입니다. 이 티켓은 긴급한가? 이 요청은 어느 모델이 처리해야 하는가? 이 셸 명령은 위험한가? 검색해 온 이 구절이 질문에 대한 답이 되는가?
여러 팀이 이런 판단을 하나하나 범용 LLM에 보냅니다. 모델은 답을 한 번에 토큰 하나씩 생성하고, 애플리케이션은 그 답을 파싱하고 검증하며, 형태가 어긋나면 다시 요청합니다. 이 방식도 작동하기는 하지만, 가능한 답이 다섯 개뿐인 판단을 처리하기에는 느리고 비쌉니다.
Jev는 바로 그런 판단을 위해 만들어진 모델입니다. TypeSafe는 Jev를 System One 모델이라고 부릅니다. 정형화되지 않은 상태가 입력으로 들어가면, 타입이 정해진 답과 확률이 출력으로 나옵니다.
그 말이 무슨 뜻이고, 어디에 들어맞으며, 어느 지점에서 마케팅 문구를 조금 절제해야 하는지 하나씩 풀어 보겠습니다.

먼저 Jev가 해결하려는 문제
LLM은 도구 호출(tool calling)과 구조화된 출력(structured outputs)이 등장하면서 소프트웨어에 연결하기가 훨씬 쉬워졌습니다.
도구 호출은 모델이 예측 가능한 형태로 함수를 요청할 수 있게 해 줍니다. 구조화된 출력은 모델이 스키마를 따르는 JSON을 반환하게 해 줍니다. 두 기능 모두 깨지기 쉬운 파싱 작업을 대폭 없애 주었습니다.
하지만 그 밑에 있는 모델은 여전히 생성 모델입니다. 답이 "billing"이라는 단어 하나뿐일 때조차, 모델은 토큰을 순차적으로 생성합니다. 사용자는 입력에 대해 비용을 지불하고, 생성이 끝날 때까지 기다리며, 출력에 대해서는 더 많은 비용을 지불하는 경우도 흔합니다.
이제 이 과정을 에이전트 루프 안에 놓아 보겠습니다.
while not done:
    action = llm(context)
    result = run_tool(action)
    context += result
모델은 도구를 고르기 위해, 결과를 판정하기 위해, 위험을 감지하기 위해, 작업이 끝났는지 결정하기 위해, 그리고 다음 모델을 선택하기 위해 거듭 호출될 수 있습니다. 에이전트를 한 번 실행하는 동안, 판단은 필요하지만 글 생성은 필요하지 않은 호출이 여러 번 발생할 수 있습니다.
Jev는 바로 그런 호출을 겨냥합니다.
Jev가 거는 승부수는 단순합니다. 코드가 이미 가능한 답을 알고 있다면, 언어 생성은 잘못된 인터페이스라는 것입니다.
Jev는 실제로 무엇인가
가장 짧으면서도 정확한 설명은 의미 기반 판단 엔진(semantic decision engine)이라는 표현입니다.
Jev에는 두 가지를 보냅니다.
- State: 현재 상황을 서술하는 텍스트 또는 JSON입니다.
- Questions: 그 상태에 대해 내리고 싶은 판단들입니다.
모든 질문은 답의 형태를 미리 선언합니다. Jev는 세 가지 기본형을 지원합니다.
- Choice는 사용자가 정의한 목록에서 하나를 고르고, 모든 선택지에 대한 확률을 반환합니다.
- Score는 낮음, 중간, 높음처럼 사용자가 정의한 순서 있는 척도 위에 입력을 배치합니다.
- Noul은 예 또는 아니오로 답하는 질문에 대해, 그것이 참일 확률을 반환하는 방식으로 답합니다.
Noul은 불리언 형태의 기본형에 TypeSafe가 붙인 이름입니다. 이 낯선 이름보다 중요한 것은 출력입니다(사용자의 코드가 그대로 활용할 수 있는 0과 1 사이의 숫자입니다).
{
  "model": "jev-latest",
  "state": "The deploy failed twice and customers are seeing 500s.",
  "questions": {
    "urgent": {
      "type": "noul",
      "instructions": "Does this need attention right now?"
    },
    "owner": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "engineering": "Product failures and outages",
        "billing": "Charges, invoices, and refunds",
        "sales": "Pricing and new accounts"
      }
    }
  }
}
응답에는 긴급도 확률과 세 팀에 대한 확률 분포가 담깁니다. 해석해야 할 문단도 없고, 모델이 지어낼 네 번째 팀도 없습니다.
프로그램은 계속 통제권을 유지합니다.
if urgent > 0.9 and owner == "engineering":
    page_on_call()
elif confidence < 0.6:
    send_to_human_review()
else:
    add_to_queue(owner)
사람들이 Jev를 똑똑한 switch 문이라고 계속 부르는 이유가 여기에 있습니다. 이 표현은 깎아내리는 것처럼 들리지만, 이 설계에서 쓸모 있는 부분을 정확히 짚어 냅니다. 분기는 평범한 코드가 소유합니다. 모델은 평범한 코드가 안정적으로 계산해 낼 수 없는 모호한 판단만 공급합니다.

LLM과 구별되는 중요한 차이
전통적인 LLM과 Jev는 둘 다 지원 티켓을 분류할 수 있습니다. 다만 답에 도달하는 방식이 서로 다르고, 시스템 안에서 쓸모를 발휘하는 자리도 서로 다릅니다.

TypeSafe는 Jev가 한 요청에 담긴 모든 질문을 병렬로 평가한다고 밝혔습니다. 이 점은 워크플로를 설계하는 방식을 바꾸어 놓습니다. 질문을 하나 던지고, 기다리고, 그다음에 어떤 질문을 할지 정하는 대신, 같은 상태에 대한 독립적인 질문을 전부 한 번의 요청으로 던져 놓고 코드가 필요한 답만 쓰게 할 수 있습니다.
이 회사는 종단 간 지연 시간이 70밀리초에서 500밀리초 사이이고, 가격은 입력 100만 토큰당 0.042달러이며 출력은 무료라고 보고했습니다. 대표 수치로 내세우는 주장은 비슷한 LLM 워크플로보다 약 200배 빠르고 400배 저렴하다는 수준에까지 이릅니다.
이렇게 큰 배수는 TypeSafe가 자체적으로 수행한 워크플로 평가에서 나왔고, 비교 조건 가운데 유리한 쪽 끝에 놓여 있습니다. 그러므로 이 수치는 모든 애플리케이션에 적용되는 약속이 아니라 상한선으로 받아들여야 합니다. 그럼에도 그 밑바탕에 깔린 이점은 여전히 신뢰할 만한데, Jev는 한정된 판단을 위해 설계된 덕분에 긴 추론 흔적과 생성된 출력을 피한다는 점이 그 근거입니다.

확률이 중요한 이유
타입이 정해진 답은 문제의 절반만 해결합니다.
Jev가 어떤 티켓을 billing으로 라우팅했다고 가정해 보겠습니다. 선택된 레이블은 무엇이 이겼는지 알려 줍니다. 확률 분포는 그 경쟁이 얼마나 접전이었는지 알려 줍니다.
{
  "choice": "billing",
  "probabilities": {
    "billing": 0.52,
    "technical": 0.46,
    "sales": 0.02
  },
  "confidence": 0.18
}
이 티켓을 자동으로 라우팅한다면 무모한 일이 됩니다. billing이 이기기는 했지만, 간신히 이겼습니다. 확신도가 낮은 답은 다른 분기를 발동시켜야 합니다.
여기에서 개발자가 쓸 수 있는 실용적인 패턴이 나옵니다.
- 확신도가 높을 때: 결과가 미치는 영향이 작다면 자동으로 실행합니다.
- 확신도가 중간일 때: 확인을 요청하거나 더 강력한 모델을 호출합니다.
- 확신도가 낮을 때: 사람에게 사건을 넘기거나 정보를 더 모읍니다.
임계값은 코드 안에 두어야 하며, 그래야 검토하고 변경할 수 있습니다. 대시보드에 붙는 레이블이라면 예측이 약해도 용인될 수 있습니다. 데이터를 삭제하는 명령이라면 훨씬 높은 기준을 요구해야 합니다.
TypeSafe는 보정된 판단을 위한 강화학습(Reinforcement Learning for Calibrated Decisions), 줄여서 RLCD라는 방법으로 Jev를 학습시킵니다. 그 목표는 여러 예측에 걸쳐 확신도가 정확도를 그대로 반영하게 만드는 것입니다. 모델이 어떤 답변 집합에 90퍼센트 확률을 부여했다면, 그 답변 가운데 대략 90퍼센트는 실제로 맞아야 합니다.
정밀한 표현이 필요한 환각 주장
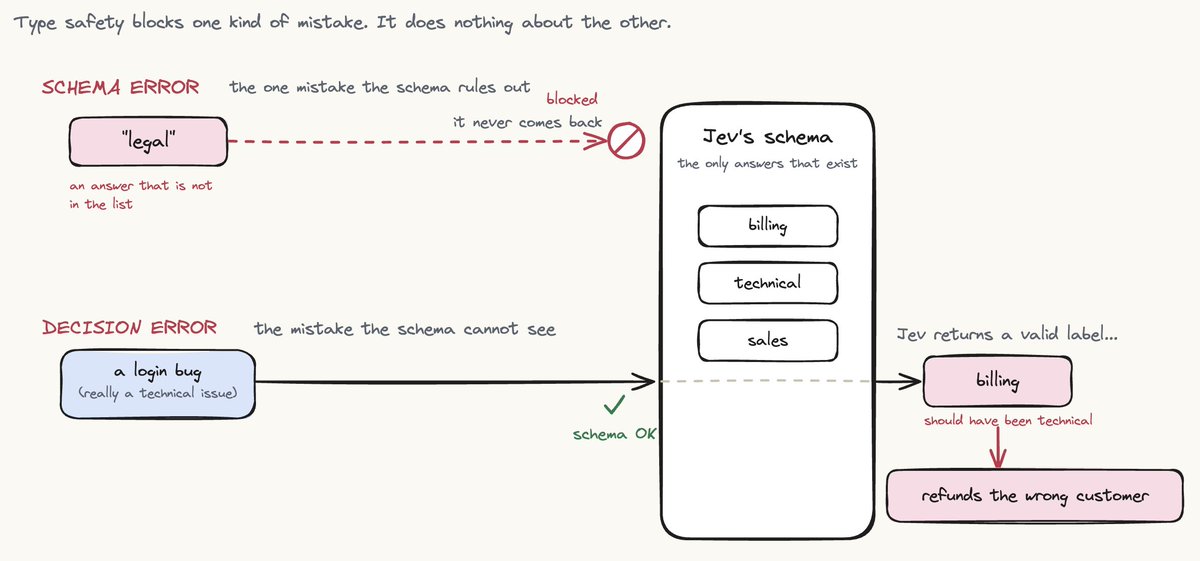
TypeSafe는 Jev가 환각을 일으킬 수 없다고 말합니다. 이 문장은 좁은 정의 아래에서만 참입니다.
Jev는 스키마 바깥에 있는 선택지를 반환하지 못합니다. billing, technical, sales를 정의해 두었다면, 응답이 legal을 지어낼 수 없습니다. 또한 코드가 레이블을 기대하는 자리에 형식이 깨진 글을 내놓을 수도 없습니다.
하지만 스키마상 유효한 선택지 가운데 틀린 것을 자신 있게 고를 수는 있습니다.
타입 안전성은 유효하지 않은 형태를 막아 줍니다. 그러나 판단이 옳다는 것까지 보장해 주지는 않습니다. 이 구분이 중요한 까닭은, 스키마상으로는 유효한 실수라도 엉뚱한 고객에게 환불을 해 주거나, 장애를 잘못된 곳으로 넘기거나, 위험한 명령을 승인해 버릴 수 있기 때문입니다.
더 안전한 문장은 "Jev는 선언된 출력 스키마를 어길 수 없지만, 여전히 틀릴 수는 있다"입니다.
에이전트 안에서 Jev가 놓이는 자리
Jev는 LLM을 대체할 때가 아니라 LLM과 함께 쓰일 때 가장 잘 작동합니다.
LLM은 언어나 더 깊은 추론이 필요한 작업을 담당합니다. 계획을 세우고, 글을 쓰고, 설명하고, 도구를 사용합니다. Jev는 그 작업 주변에서 자주 발생하는 판단을 담당합니다.
특히 설득력 있는 배치가 세 가지 있습니다.
모델 라우팅
단순한 조회에는 아키텍처 검토와 같은 모델이 필요하지 않습니다. Jev는 요청을 채점해서, 그 요청을 완수할 수 있을 법한 모델 가운데 가장 저렴한 것을 고를 수 있습니다.
route = jev.choice(
    state=user_request,
    options={
        "fast": "Lookups, extraction, and small local edits",
        "powerful": "Architecture, ambiguity, and high-stakes work",
    },
)

model = fast_model if route == "fast" else powerful_model
라우터는 요청에 답하지 않습니다. 어느 모델이 답해야 하는지 결정할 뿐입니다.
도구 위험 게이팅
에이전트가 셸 명령을 실행하기 전에, Jev는 그 명령을 읽기 전용, 되돌릴 수 있음, 파괴적임으로 분류할 수 있습니다. 그 명령이 파일을 삭제하는지, Git 히스토리를 변경하는지, 프로덕션을 건드리는지, 저장소 바깥으로 벗어나는지는 각각 별도의 질문으로 확인할 수 있습니다.
확신도가 높은 읽기 전용 동작은 그대로 진행해도 됩니다. 파괴적이거나 불확실한 동작은 사람의 승인을 받도록 멈춰 세울 수 있습니다. LangChain이 제공하는 Jev 연동은 도구 호출을 실행 전에 검사하는 미들웨어를 통해 이 패턴을 적용합니다.
검증과 감독
에이전트는 테스트가 아직 실패하고 있는데도 작업이 끝났다고 주장할 수 있습니다. Jev는 상태를 살펴보고 한정된 질문에 답할 수 있습니다. 테스트가 통과했는가? 에이전트가 같은 동작을 반복하고 있는가? 출력이 정책을 따르고 있는가? 이 결과는 검토를 거쳐야 하는가?
이미 엄밀한 테스트가 존재한다면 Jev가 그것을 대체하지는 않습니다. 다만 규칙이 의미에 좌우되는 자리에 의미 기반 검사를 더해 줍니다.

오늘 Jev로 해결할 수 있는 문제들
가장 좋은 사용 사례에는 세 가지 공통점이 있습니다. 가능한 답을 이름 붙여 나열할 수 있고, 주의 깊은 사람이라면 그 입력을 빠르게 판단할 수 있으며, 그 판단이 지연 시간이나 비용을 신경 써야 할 만큼 자주 일어납니다.
지원과 운영
- 의도, 긴급도, 담당 부서, 스팸 여부, 고객의 불만 수준을 분류합니다.
- 환불과 정책 예외를 여러 개의 작은 검사를 거쳐 처리합니다.
- 사람이 읽기 전에 로그와 장애를 의미상 심각도 순으로 정렬합니다.
한 번의 요청으로 같은 티켓에 대해 이 질문들을 모두 물어볼 수 있습니다. 그다음에는 코드가 그 답들을 조합해서 회사가 실제로 사용하는 라우팅 정책을 구성합니다.
검색과 리트리벌
- 검색해 온 구절이 질의에 답이 되는지를 기준으로 순위를 다시 매깁니다.
- 어떤 인용이 주장을 뒷받침하는지 확인합니다.
- 비싼 LLM에 컨텍스트를 보내기 전에 관련 없는 청크를 걸러 냅니다.
임베딩은 의미상 관련 있는 텍스트를 찾아내는 데 탁월합니다. Jev는 이 질문에 대해 특정 구절이 쓸모 있는지라는 더 좁은 판단을 내려 줄 수 있습니다.
품질과 안전
- 프롬프트에 탈옥 시도나 프롬프트 주입이 있는지 선별합니다.
- 생성된 콘텐츠를 정책이나 평가 기준에 비추어 검사합니다.
- 위험한 코드 변경이나 도구 호출을 실행되기 전에 표시합니다.
이런 검사는 결정론적인 통제 수단 옆에 자리해야 합니다. 의미 기반 분류기는 모호한 위험을 다루는 데 쓸모가 있고, 권한과 샌드박스와 테스트는 소프트웨어가 정확하게 검증할 수 있는 규칙을 강제합니다.
대량 분류
- 문서, 연구 논문, 상품 목록, 고객 메시지에 레이블을 붙입니다.
- 자유 형식 텍스트를 전통적인 머신러닝 모델이 쓸 피처로 변환합니다.
- 대규모 말뭉치의 모든 항목을 같은 평가 기준으로 채점합니다.
호출당 비용이 낮다는 점이 벤치마크 숫자 이상의 의미를 갖는 자리가 바로 여기입니다. 모든 행에 대해 실행하기에는 너무 비쌌던 판단을 이제 평범한 데이터 파이프라인 안으로 옮길 수 있습니다.
실시간 인터페이스
- 알려진 페이지 요소 가운데 다음 브라우저 동작을 고릅니다.
- 사람이 글을 쓰는 동안 어조나 명료성을 채점합니다.
- 구조화된 게임이나 시뮬레이터 상태에서 행동을 선택합니다.
Jev는 현재 텍스트만 다루므로, 이런 시스템은 환경을 먼저 텍스트나 JSON으로 변환해야 합니다. Jev가 화면을 들여다보거나 픽셀을 보고 게임을 하는 것은 아닙니다.

Jev가 잘못된 선택이 되는 경우
답의 공간이 더 이상 알려져 있지 않게 되는 순간부터 Jev의 쓸모는 줄어듭니다.
- Jev는 응답을 작성하거나, 문서를 요약하거나, 코드를 생성하거나, 자신의 추론 과정을 설명하지 못합니다.
- 산술, 개수 세기, 날짜 비교, 정확한 문자열 조작에는 믿음직하지 못합니다. 그런 연산은 코드에 맡겨 두어야 합니다.
- 하나의 판단에 드러나지 않은 추론 단계가 여러 개 필요한 경우에는 어려움을 겪습니다. 그 판단을 더 작은 질문들로 쪼개거나 추론 모델을 사용해야 합니다.
- 알려지지 않은 값을 직접 추출하지는 못합니다. 후보 값을 먼저 찾아낸 다음, 그중에서 Jev가 고르게 해야 합니다.
- 관련 없는 컨텍스트는 정확도를 떨어뜨릴 수 있습니다. 판단에 필요한 상태만 보내야 합니다.
- 비공개 가중치와 초기 접근 단계, 텍스트 전용 입력이라는 제약, 그리고 독립적인 보정 데이터가 부족하다는 사정 때문에, 아직 맹목적으로 신뢰하기에는 이릅니다.
더 단순한 규칙도 하나 있습니다. 결정론적인 코드가 이미 문제를 올바르게 풀고 있다면, 그 코드를 그대로 두어야 합니다. 평범한 if 문이 어떤 모델보다도 빠르고, 저렴하며, 테스트하기 쉽습니다.
새로운 실패 유형을 만들지 않으면서 Jev를 사용하는 방법
저렴한 모델이라도 그 실수가 재시도와 수작업 검토, 프로덕션 장애를 불러온다면 결국 비싸질 수 있습니다. 토큰 가격이 아니라 워크플로 전체를 측정해야 합니다.
합리적인 도입 절차는 다음과 같은 모습입니다.
가능한 답이 분명한, 한정되고 위험이 낮은 판단을 하나 고릅니다.
모델을 호출하기 전에 평가 기준을 먼저 작성합니다. 각 선택지에 무엇이 속하는지를 정의합니다.
모호한 사례와 적대적인 사례까지 포함해서, 기대하는 답이 붙은 대표 사례들을 모읍니다.
현재 워크플로 옆에서 Jev를 섀도 모드로 실행하되, 동작을 바꾸지는 못하게 합니다.
정확도를 확신도에 대한 그래프로 그려 보고, 확보한 데이터로부터 임계값을 정합니다.
가장 안전한 분기부터 자동화하고, 불확실한 사례에는 사람이나 더 강력한 모델을 남겨 둡니다.
모델 버전, 질문, 판단 기준, 임계값을 고정하거나 기록해 두어서, 변경 사항을 같은 평가 집합에 대해 재현할 수 있게 합니다.
질문은 프로그램의 일부입니다. 질문을 코드처럼 다루어서 버전을 관리하고, 검토하며, 모델이나 판단 기준이 바뀔 때마다 테스트해야 합니다.

실제로 일어나는 변화
Jev가 흥미로운 이유는 글쓰기에서 LLM을 이기기 때문이 아닙니다. Jev는 글쓰기를 아예 거부합니다.
Jev가 기여하는 바는 소프트웨어와 같은 모양을 한 모델 인터페이스입니다. 답의 타입이 고정되어 있고, 불확실성이 명시되며, 질문이 병렬로 처리되고, 분기를 코드가 통제합니다.
그래서 Jev는 생성 모델에게 쓸모 있는 동반자가 됩니다. LLM은 계획과 설명, 코드를 만들어 냅니다. Jev는 요청을 라우팅하고, 위험한 동작을 통제하며, 결과를 검사하고, 불확실성이 충분히 높아서 상위 단계로 넘겨야 하는 시점을 결정합니다.
이 더 큰 발상은 언젠가 다른 모델이 Jev를 대체하더라도 여전히 중요합니다. 우리는 생성 모델에게 온갖 종류의 지능을 텍스트로 발휘해 달라고 요청하며 여러 해를 보냈습니다. 많은 프로덕션 시스템에는 더 많은 말이 필요하지 않습니다. 그 시스템들에 필요한 것은 평범한 소프트웨어가 안전하게 사용할 수 있는, 작고 빠른 판단입니다.
Jev가 만들어 내려는 범주가 바로 그것입니다.
어디에서 시작할 것인가
에이전트를 Jev 중심으로 다시 짓는 일부터 시작하지 마십시오. 지금 느린 LLM 호출을 필요로 하거나, 자꾸 깨지는 정규식에 의존하고 있는 판단을 하나 찾아내십시오.
Jev에 최소한의 상태만 주고, 가능한 답을 정의한 다음, 그 확률을 현재 결과 옆에 기록해 두십시오. 워크플로 전체를 넘기기 전에, 분기 하나를 맡을 자격이 있다는 점을 먼저 증명하게 하십시오.
가장 쓸모 있는 멘탈 모델은 여전히 가장 단순한 것입니다 → Jev는 평범한 if 문이 값은 이해하지만 그 값의 의미는 이해하지 못하는 자리에 판단을 더해 줍니다.
출처와 더 읽을거리
- TypeSafe AI: Introducing System One Models and Jev
- LangChain: Building a Harness with Jev
- Flavio Copes: A deep dive into Jev
즐겁게 읽으셨기를 바랍니다.
다음 글에서 다시 뵙겠습니다.
Cheers! :)